SIerに就職したので感想とか
ふかふかです。
TCU-CTRL場外乱闘 Advent Calendar 2025の16日目の記事です。他の記事はこちらから
TCU-CTRL場外乱闘 Advent Calendar 2025 - Adventar
この春大学院を卒業して大手SIerに就職しました。直近の同期・先輩に似た進路の人があまりいなかったので、大手SIerに就職・転職を考えている人向けに正直どうだったのか体験談を書きます。
細かいところはぼかして書くので詳しく聞きたい人はX等で連絡してください。
- この記事で書くこと
- この記事で書かないこと
- 就職先・配属について
- 就職先選択理由
- 就活の流れ
- SIerの現時点での良かった点
- SIerの現時点で期待外れだった点・注意点
- SIerの現時点では良いとも悪いとも言えない特筆点
- 最後に就活アドバイス
- 追伸
この記事で書くこと
この記事で書かないこと
- SIerとは何なのか等の基礎的概念
- 細かい技術の話(あまり普遍性が無いので)
就職先・配属について
国内最大手級のSIer(システムインテグレーター)に就職しました。会社にはSI以外の事業もありますが、配属先としてはSI事業になる前提の募集で就職しました。
就職後は1ヶ月ほど全体研修→2ヶ月程度の職種別研修→配属といった流れでした。
配属先はシステムの運用を主に行うチームです。業務としては現時点では大規模なシステムを海外子会社のチームを監督して運用するプロジェクトがメインで、海外子会社の扱いが慣れていると言うことでそれ以外にも海外子会社絡みの業務移管の仕事がありました。
就職先選択理由
SIer業界に就職した理由を書きます。業界内で今の会社を選んだ理由は内定が取れた中で業界最大手だったからと言うところが一番大きいので、その点については特筆すべき所は無いです。
就活中の方向性としては、大学・大学院が情報系ということで就職先はいわゆるIT系を念頭に置きつつメーカーやゲーム業界なども検討していました。職種としても典型的なシステムエンジニアからR&Dまでひとまず広く考え、そこから絞り込んでいきました。
SIerを選んだ理由としては以下がメインです。
- いわゆるプログラミングといった実作業としての個別のエンジニアリングはそれほど好きではなく、ビジネス的観点も踏まえた総合的な視点で仕事をしたかった。
- サークル活動等も経て、自分にクリエイティブ的仕事に対するこだわりが無いことが分かった。
- 両親がSIer業界で、親しみ・知識があった。
自分の中の進路選択の方向性として技術とビジネスと言う2つの軸についてどのようにバランスを取っていくか考えた際に、将来の選択肢や待遇、安定性等を踏まえて最もバランスが良かったのが大手SIerだったといった感じです。
就活の流れ
学部3年から断続的に各業界のインターンや説明会参加→修士1年春にはSIerを第一希望に→随時インターンや選考応募し4月下旬に現在の就職先に内定
といった流れ。当時は国内SIerは1月〜3月ごろから本選考の募集をする例が多かったので、その頃が特に就活で忙しかったです。
内定獲得企業はSIer3社、メーカー1社、自社サービス2社といった感じ。ただし志望度の高めなSIer一社から早期に内定獲得しその後内定受諾回答までかなり長い期間時間があり、その後は志望度の高い所に絞って活動したため心理的余裕はかなりありました。
あまり就職体験記をたくさん書くと記事の論点が散らかるので、就職アドバイスは最後に要点だけ簡潔に書こうと思います。
SIerの現時点での良かった点
1.待遇・福利厚生
待遇はまあまあ良いです。
いわゆるDXやAI需要による業績の好調、人員の需要という状況もあり、待遇は(世間のイメージよりは)良いなと言う印象があります。初任給は年々変化するため一概には言えませんが、一般的なメーカーの水準よりは少し高い印象です。IT系の高い初任給と比べると額面上はやや安めですが、残業代が全額出る(みなし残業代が含まれない)のと、福利厚生で寮が使えるというメリットがあり、これがとてもありがたいです。
個別の企業の事例についてはそれぞれで確認してほしいのですが、自分の会社の場合は寮は会社が借りた指定された一般のアパートに入居する(光熱費自己負担)という形で、基本的には築浅のワンルームが割当てられるようです。自分の場合は当時築5年程度の約25平米の部屋で、同物件を不動産サイトで見ると月9万円でした。寮費が約1万円なので、家計的にはかなりの金額が浮きます。利用できる年数は限られるのでそれ以降は自分で部屋を借りる必要がありますが、それを踏まえても給与の中で実質的に使える金額については就職難易度の近い自社開発系の会社と比べても遜色ないのではないかなと思います。この辺はメーカーに多い嬉しい福利厚生ですね。
金銭換算でインパクトの大きい福利厚生としてはそのくらいですが、それ以外の大企業特有の特筆すべき福利厚生としては団体保険と持株会があります。団体保険はとにかくグループの規模のスケールメリットが効くので一般の水準と比べてもかなり割引が大きいです。また、持株会は資産と勤務先が一致するというリスク分散の点での懸念がありますが、企業としての安定感がいわゆるメガベンチャー等と比べて違うので奨励金の制度によってはかなり嬉しい制度です。(まあ東芝みたいに上場廃止で持株会廃止みたいなシナリオもないわけじゃないけど)
2.社会的信用がある
大企業には知名度と信用があります。
会社の社会的地位や知名度と個人の評価というものは全く別ではありますが、知名度のある会社に就職できたというのは親戚にも話しやすいですし、親も安心させやすいというのは大きいと思います。自分の場合は親が業界人だったので業界内の立ち位置と親の認識がある程度一致している認識もあり、あまり気負わず就活しましたが、親がその辺を気にするといった場合なら悪くない選択肢だと思います。一応自分の自尊心も満たせますし。
3.一般水準的には教育が充実している
自分の入社したところもそうでしたが、大手SIerは一般的な観点で言えば教育が充実していると言って差し支えないかと思います。
ただし、後に述べますが新入社員の技術的レベルが高くないので、新入社員向けの職種別研修も初心者前提といった感じ経験がある層には少し物足りず知識・技術的に勉強になるといった感じでは無いです。とはいえ、初心者も入れてチーム開発するというのもそれはそれで様々なレベル感の中で仕事をする経験になります。
また、配属後もハンズオン環境付きで利用できる研修や、学習用の環境の貸出(特にクラウド系)が多く、まあ機会は充実しているな、という印象はあります。ただし、研修内容的には旧来のウォーターフォール型開発が前提のものやひと回り古い技術スタックを扱ったものが多く、いわゆるアジャイル・DevOps的開発スタイルや、よりモダンな技術については結局OJTか自分で勉強する事になりそうな感じです。Udemy Business等の学習サービスは色々使えるので、やる気があるならいいと思います。
SIerの現時点で期待外れだった点・注意点
1.いわゆる配属ガチャ(地方配属)がある
大手SIerの注意点として、配属先のばらつき(特に地方配属)があります。一応配属希望は聞かれますが、確約はありません。
何分巨大な企業なので、様々な業務様々な勤務地があります。私は運良く本社周辺の拠点でインフラ系の業務の配属でしたが、北は北海道南は沖縄まで、地方に配属されて興味ない分野(例えば顧客寄り)の仕事をして数年間戻ってこれない可能性があります。また、在宅勤務の可否も配属先に依存します。自分の配属先は9割方在宅勤務(出社したければしても良い)ですが、配属先・案件によっては出社が基本であったり、逆に予算が厳しいから必要なければ在宅で、というチームもあります。ただしこれは配属先確約の採用ルートであればある程度(組織改編リスクはあるが)回避可能です。
2.平均的部署・メンバーは技術的志向度が低い
大手SIerの社員は(特に一般的SI部門での話。R&D等は別)特別技術に関心があるわけでは無いです。
もちろん仕事に必要となる知識はありますが、良くも悪くもサラリーマンといった感じで、最近の技術トレンドに敏感とか、特定の分野に特に詳しいといった人は身近なメンバーでは限られます。もちろん会社全体で見ればトップ層はレベルは高いですが、そういったキャリアにはポスティングの活用など、積極的な行動が必要になってきます。
この傾向は新入社員も同様で、研究所配属での採用者など優秀な人も居はしますが、私の採用ルートの配属先確約なしのエンジニア職一括採用では文系出身のプログラミング未・微経験者もかなり(30%以上)多かったです。この採用ルートで自社開発系の企業での採用基準を満たす技術力のある人は多めに見積もっても15%未満といったところではないでしょうか。
個人的には技術的な込み入った話ができる人がもう少し多いと思っていたので、その点はやや期待外れでした。
ただ、今後は採用方針を転換してより即戦力級の人材を採る方針のようなので、これからは分からないなといった印象です。
3.会社の総合的利益ではなく部門の利益のための仕事をしなければならない時がある
大規模な企業では制度や目標設定の関係で正直これどうなんだと思う仕事もしなければならない、というのが配属後の不満として感じました。
まず前提として最初の方に海外子会社と仕事をしているという話を書きましたが、会社としてはこれまで国内の協力会社に委託していた仕事を海外子会社にどんどん移していきたいという方針があります。まあその方針自体は理解できるのですが、その弊害としてブルシット・ジョブとまでは言わないにしても、かなり生産性の悪い仕事に最近取り組んでおり、それによって現状かなりやる気を削がれています。
具体的イメージとして、特定の定型タスクを抽出して海外子会社に移管するといった流れを想像して下さい。社内の別部署の行なっている業務について担当部署から依頼を受け、海外子会社メンバーの教育や監督、発注手続きに慣れている今の配属先チームが協力して移管します。一見、人件費の高い日本の社員や協力会社が担当していた作業を人件費の安い国外のオペレーターにやってもらって人件費削減!と書けばとても良いように見えます。しかしながらそれを実際にやってみようとすると、
- 日本の関連知識の豊富な人向けにテキトーに書かれた手順書を英語で細かく分かりやすく書き直す手間がある(PC経験無しのの高卒新入社員でも間違わないくらいのレベル感)。
- 現行の運用メンバーも含めて沢山の日本側社員と海外メンバーを集めて何度も練習する(しかもしばしば作業手順の改訂がある)。
- それで移管成功しても人員の関係でしばらくは病欠等で欠員が出たら日本側でフォローが必要。
と、かなり手間がかかります。
作業の移管に伴うコスト削減効果が手間に見合うのであればいいのですが、そもそも海外移管できるタスクという時点で、マニュアル作業を逸脱しない定型タスクである前提条件があります。そうなると冷静に考えれば"ここまで工数かけて海外に移管するならその工数で作業を自動化した方がいいのでは"という判断になりそうです。しかしそういった事は依頼を受けて移管作業を行なっている配属先チーム側からは言いにくい(チームの業務成果になるので断りにくい)ですし、依頼側部署としても業務の海外移管が目標設定されているのでコストとは別の思惑も含めて移管依頼しているという状況があります。結果として、会社のトータルでは合理的判断と思えない無駄の多い仕事を現場として実施するという結果になります。こんな感じで、会社全体の方針により効率的とは思えない仕事がたまにあるというのが大企業の悪いところになります。
SIerの現時点では良いとも悪いとも言えない特筆点
1.AI活用が早くない
これは大企業ゆえ仕方ない点もありますが、AI活用のレスポンスは早くないです。
標準で使えるのは利用シーンはちゃんと考えられているけどAIの発展に開発速度が追いつけていない社内ツールと、開発ペースはともかく使い勝手の微妙なMicrosoft系ツールくらいです。AI利用ルールがちゃんと策定されていたり、プロジェクト単位でAI関係ツールを独自導入できる裁量はあるとはいえ、もう少し早くトレンドに追従してほしいというのが正直なところです。早くReasoningモデルを導入してDeepResearchを使わせろと歯がゆい思いではあります。とはいえGithub Copilotは使えますし世間の標準と比べると十分早いという印象はあり、遅いとはいえ機能も拡充されつつあるので、あまりここに文句を言うのもな、という感じです(とはいえChatGPT Plusくらいは使いたい)。また、AI活用云々はかなり社内で注目されているトピックなので、その辺を活用した効率化タスクに取り組めば、当分の間はやる事に困らないなという実感もあります。
最後に就活アドバイス
要点だけ書きます。
大手SIerの最近の傾向として、インターン経由偏重と即戦力重視の配属先確定採用という点があります。インターンについては学部3年・修士1年春から忘れずに情報収集と応募に取り組んでほしいとしか言えないのですが、難しいのは配属先を確定させる方式の採用プロセスです。企業により異なりますが、かなり細かい部署・事業レベルで志望理由を提出する必要があります。正直細分化しすぎて志望動機が書きにくい事があるので、時間的余裕を十分にとって(締め切り直前に急いで書くのではなく)座談会等の現場の人に話を聞ける機会を適切に利用して希望配属先の選択や配属先の志望理由の作成を行ってください。
また、推薦が利用できる場合があります。大手は学内推薦の説明会を行う場合があるので学番メール等は忘れずチェックしてしてください。特にメーカー系SIerの場合はリクルーターに相談してみるのも良いと思います。
追伸
リファラル採用やってます。紹介した人が入ると少し奨励金が入るので、中途入社で検討している人は分野に関わらずぜひ連絡ください。
小中学生を教えてわかったプログラミングの指導法
こんにちは。ふかふかです。CTRLアドベントカレンダー2024 12/19ということで、バイトで小中学生にプログラミングを教えて感じた事を書いていこうと思います。せっかくなのでなるべくキャッチーなタイトルにしてみました。
前の人はマキアさんです。
記事の内容
教えてわかった世間の偏見とは異なる興味深い傾向を紹介する。
プログラミングが不得意な人間にどうやってプログラミングを教えるかを考える。
今しているバイト
ロボット制作・プログラミング教室
卒業まで続けるつもりなので、あと3か月くらい勤務する予定です。三年程度続けたことになります。当然細かいところはぼかしています。
なぜこのバイトを始めたか
自分の知識や経験を活かせるバイトがしたかったのと、家から近くて規則が緩めだったから
元々塾講師のアルバイトをしていたのですが、諸条件が合わず学部3年のころインターンシップで予定が合わなくなったこともあり退職し、その後今のバイトを始める。
どんなところか
中小規模のプログラミング教室
未就学児~小4くらいまではカリキュラムベースの少人数授業、それ以降は大会を念頭に置いた個別指導に段階的に移行していく
自社教室での授業に加えて、民間学童保育室の習い事サービスに派遣されての授業の実施があった。
教材
カリキュラムベースの指導ではレゴ社のプログラミング教育用教材が中心
ロボット大会ではLEGO MINDSTORMを利用していたが終売して移行先が定まらずにいる。LEGO SpikeとM5 Stackが候補だが前者は拡張性、後者は内蔵電池等のレギュレーション対策に難があり完全移行には至らずにいる。
ある程度経験を積んだら中学生前後で機体構造材などから自作するスクラッチビルドに移行する。その場合はArduinoを使う例が多い
いいところ
(塾講師と比べて)服装規定が緩かった
自身の知識や興味が活かせた
(塾講師と比べて)目先の模試などの短期的目標ではなく、根本的理解を目的とした指導ができた。
よくなかったところ
あんまりシフト等に自由度が無い
やる気の無い子供もたまにいる
向き不向きが分かれそうなところ
難易度自体は大したことないが、指導に要する知識・スキルセットが広範にわたるので、情報収集や自己学習が得意でないと辛そう
ロボコンについて
ロボカップジュニアジャパン公式サイト | 次世代のロボカップの担い手を育てます
こんな感じの雰囲気の大会に出場することが多いです
1~3人チームで1~2台程度のロボットを使います。
サイズ感は一辺15~50cmくらい ライントレースをベースとして様々なタスクや障害があるルールや、対戦型でサッカーを行うルールなどがあります。傍流的雰囲気はありますが、シミュレーションで実施しソフトウェアのみの性能を競うルールや、ロボット等を用いたパフォーマンスで競う部門もありました。
また、小学生対象にはLEGOのキットのみで完結可能な比較的簡単なルールを採用するなど、難易度調整を行っていました。
プログラム教材について
LEGO系の教材が主力であるため、それらのプログラミングツールを用いることが主でした。LEGO MINDSTORMでは画面上にアイコンを配置する形式のプログラミングが、SpikeはScratchに近い形式のブロックプログラミングが用いられます。Scratchは地元の小学校で利用しているため、指導は比較的スムーズでした。
↓値段は高いが教材としては最高のLEGO社の教材
本題:プログラミングを確実にできるようにするには
プログラミングはできる人/できない人に二分されるという説が存在します。あるいは、優れたエンジニアを育成する確実な方法が無いといった話は聞いたことがあるかもしれません。CTRL関係者はプログラミングができる立場の人が多いと思います。しかし、必ずしもそのような人間だけで仕事ができるとは限りません。なるべく再現性が高いプログラミングの初級教育のヒントを小学生~中学生に指導した経験から書いていきたいと思います。
結論だけ先に書いてしまうと、時間をたっぷり使って丁寧に指導するのが一番確実です。あと、休みの日に自分から勉強したり趣味で開発をするような、いわゆる強強エンジニアを育てる方法はありません。
プログラミングできる/できないの元ネタ
そもそも、一般的に言われているプログラミングできる/できないがはっきり分かれるという話の元ネタは、以下の一般にはフタコブラクダ論文と呼ばれる論文で40%の学生しかテストを通過しないという記述だと思われます。
この論文自体は結論の飛躍を理由に撤回されています(Camels and humps: a retraction)が、同じように全くプログラミングができない人を一定割合で学内/同僚で見かけたことがあるのではないでしょうか。
プログラミングの向き不向き
では、プログラミングを行うという行為に向き不向きは存在するのでしょうか。指導経験上、これは半分正解で半分不正解といったところです。というのも、プログラミングを積極的に楽しめる、いわゆるものづくり等が好きなタイプの児童は明確にプログラミングに"向いている"一方で、受動的に必要があってプログラミングを行うということができない"向いていない"児童はかなり限られるためです。開発を主導するような、最新技術への関心の高いエンジニアを再現性の高い形で育成するのは不可能でしたが、メンバーなどの立場で戦力となるエンジニアはある程度安定して育成可能ではと感じます。
先の論文では、計算機科学における序盤のハードルとして
- 代入とシーケンス実行
- 再帰と繰り返し実行
- 並列実行
が挙げられています。
小中学生に指導した経験においては、十分な助言と指導のもとでブロックプログラムで数十行程度をプログラムする形で、一つ目と二つ目の項目は向き不向きには関係なく対処可能という印象です(もちろん、管理コストに見合うかや、高度な作業が可能であるかの観点は別)。
これ以上の作業者として自走がレベルが可能かどうかは、アルゴリズム検討や実装を行う方法論の知識とそれを行えるだけの根気を持っているかに依存する印象があります。とはいえ、この辺は本人の経験と発達段階に依存するので小中学生であれば年月とともに改善し、高校生くらいで大抵モノになっています。トータルで見れば、80%以上はそれなりにできるようになっているといったところでしょうか。
ちなみに、指導上ではプログラミングができる/できないという傾向には男女差はあまりありませんでした。教室に通う児童は圧倒的に男子の方が多かったですが、受講制度上男女比が均等に近かった学童保育での授業では能力に大きな差がありませんでした。ロボコン等のものづくり系の活動がとても好きなタイプの児童は男子の方が多いですが、それらは外れ値みたいなもので、それ以外の一般児童内ではあまり関係が無かったです。教室に通う児童の男女比は親の認識のバイアスの影響が強いのかもしれません。興味深いです。
また、中学までの数学能力との特異的な相関もあまり感じませんでした。正直小中学生レベルでは算数の成績などは単純な計算速度/精度の影響が強いのかもしれませんし、成績をしっかりと確認したわけでもありませんが、シンプルに全科目の成績に影響する認知能力や情報処理能力との相関がある気がします。
プログラミングができない人は何がわからないか
初歩的なプログラミングの習得に行き詰まる人の多くは、プログラムによって規定される基本的なルール・挙動が正確に内面化できていないないです。その結果、プログラムを脳内でシミュレートできず、実行結果を確信できずにあてずっぽうやコピペで実装しています。プログラミングができる人が行っているように、問題が発生した際も一行ずつ処理をたどって原因を発見したり、目的を達成できる手段を情報収集して現在の状態に応用させて使用したりすることができません。
基本的な概念・知識をどのように習得させるか
したがってプログラミングができない人が行うべきことは、自分自身でコンピューターの行動を再現させて、プログラミングの規則を体感して覚えることです。つまり、プログラムの挙動をシミュレートして実際と一致するよう訓練します。
バイト先での指導では、児童と一緒にプログラムを確認し、命令を一行ずつ実行したらどうなるかをホワイトボード等でメモしながら行き詰まったところを確認しています。大抵の場合プログラム言語等の文法などを子供達は大体は認識していますが、思い違いや曖昧な部分があるのでその都度訂正や教材の確認を行います。
できれば簡単なプログラムなどは脳内だけでスムーズに再現できるといいと思いますが、まずはメモなどを用いて時間がかかっても確実にできることが大事です。
ただし、この方法は結構手間がかかります。バイトでの経験では、指導側と児童側の割合が個別指導塾と同等、つまり先生1人に生徒2~3人程度が一度に見ることができる限界です。
アルゴリズムの検討の練習
特にロボコン競技等に挑戦する場合、一定の決まりに従ってアルゴリズム等を検討・実装する場合があります。アルゴリズムと言っても大抵の場合、最大でもAtcoderのABCのC問題程度の複雑性であり、知識というよりも様々なケースを考慮して一貫性を持った実装ができるかがネックになります。こういった状況では、とにかくフローチャートと図を書き、それに従って実装するという流れを徹底させました。
例として、一本の幅のある黒線を一個の色識別センサーを用いてライントレースするという状況を考えます。この場合、センサーが線と線の外側を往復するようなアルゴリズムが想定できます。
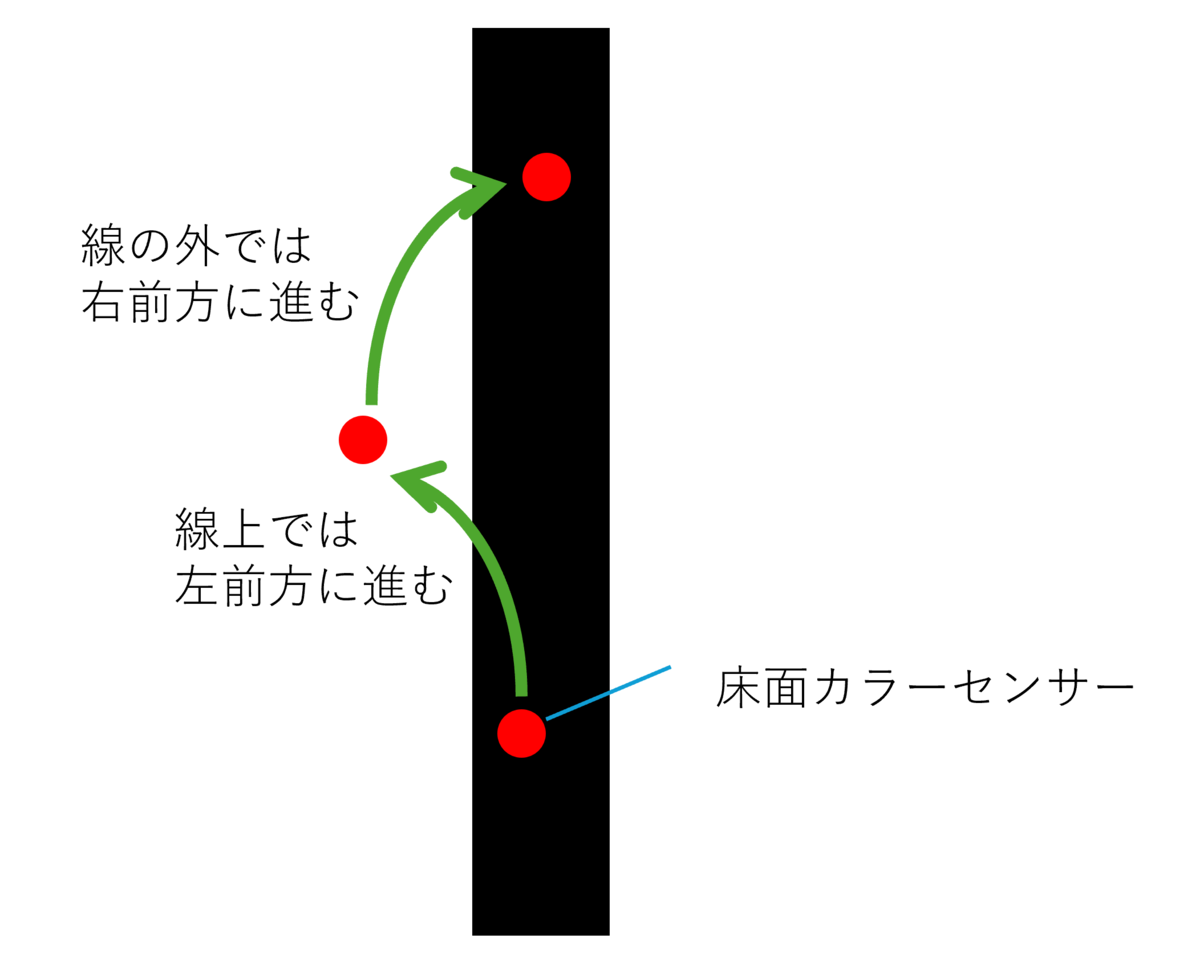
子供達のミスとしてはロボットの行動判断基準がファジーで実装不可能というものが多いです。子供達が考えたアルゴリズムの内容を聞いてみると、線がカーブしているかどうかで動きを変えると言うなど、ハードウェア的に不可能な考えをしていることがしばしばあります。また、この例であれば左右カーブの状況のような、エッジケースの検討が不足している場合もよくあります。これらの事例も、ある種脳内で自身のアルゴリズムをシミュレーションしてテストする能力が無いために発生していると捉えることができます。
こういった考慮不足を容易に改善する指導方法は見つかっていないので、経験と知識を積ませることを念頭においてその都度アルゴリズムのデバッグ方法を指示する形で私は指導しています。実際の授業では、フローチャートの作成やロボットの動きの再現してのシミュレーションでアルゴリズムが成立するか試したり、児童の案が成り立ちにくい条件を実行させて検討不足を認識させたりしました。
加えて、指導経験上大分部の小学生と結構な割合の中学生が、複数の拘束条件や例外的状況を考慮に入れたアルゴリズムの検討を苦手としていました。これについてはチェックシート形式でまとめて頻繁に確認したり、プログラムの改良ごとにそのルールでの全要素を入れたテストコースで試走させ、失われた性能が無いかをチェックしています。
このようにアルゴリズムの考案と検討はプログラミング自体の学習より難しいタスクです。このあたりの技能の習得は純粋なアルゴリズムや数学の知識というよりも、いかに要件の見落としなく実現可能な形でまとめるかという話になっています。頭の中だけで完結させるのは期待せず、全力でメモ等の記録やテストの仕組みを使う、あるいはそれらの作業を怠らせないというのが現実的な学習方法ではないかと思います。
教育に適した言語
ところで、初歩的なプログラミングの教育をするにあたって、どの教材/言語を用いればいいのかという話はいろいろありますが、個人的には日本語(母国語)が利用可能であることがかなり重要と感じます。
一般的なプログラミング言語(CとかPython)を用いた際に利用される予約語や概念は英語です。そのため、小中学生のような英語に長けていない人間がこれらを学習しようとするとそれらの単語の意味まで把握せねばならず、負担が大きくなります。大学生程度でも英語が苦手な事がプログラミングの学習の妨げになった例は見たことがあります。
プログラミングで仕事をしたり、高度なロジックを実装しようとするのならばそれらは避けては通れませんが、初歩的なプログラミングの概念を学ぶという目的では英語の存在は邪魔です。たとえ移行という二度手間があったとしてもまずは日本語で勉強(選択肢はScratchか、なでしこ程度だが)というのも手だと思います。
まとめ
長々と書いてしまいましたが、プログラミングができない原因はプログラムが脳内でエミュレートできないからというのが私の見たてです。これを改善するには、実際にプログラムと同じ処理を手計算し、どのような順序でどんな処理をしているのかを体験して知ることと、これを補助するためにメモや実物などのツールを遠慮なく使うことが大事です。この辺ができるようになれば、高校生までのロボコンで困らないくらいプログラミングできるようにしたり、Atcoderで入茶するくらいはなんとかなるのではないかと思います。
最後になりますが、今回紹介した方法で育つようなとりあえずプログラミングができるレベルの人ではなく、自分から積極的に勉強し、開発を趣味とできるような強力な人材を育てる方法を知っている方はぜひ教えてください。とても知りたいです。
ご意見ご感想あればコメント・連絡ください。
EVE Online Swagger Interface(ESI)を使う①
EVE ESIとは
CCP GamesのEVE Onlineには、ユーザーがアクセスしてゲームデータを取得・変更でき、サードパーティソフトウェアに利用できるAPIがあります。
このAPIは、正式名称のEVE Online Swagger Interfaceを略して、ESIと呼ばれます。
クラウドの勉強がてら、ESIを使ったWebアプリでも作ろうかと思ったのでメモしておきます。
とりあえず今回は認証などが不要なAPIを使ってみます。
ESIの概要
ESI仕様ページではLegacy、Latest、Devの3バージョンが記載されています。この記事では原則Latestを参照します。
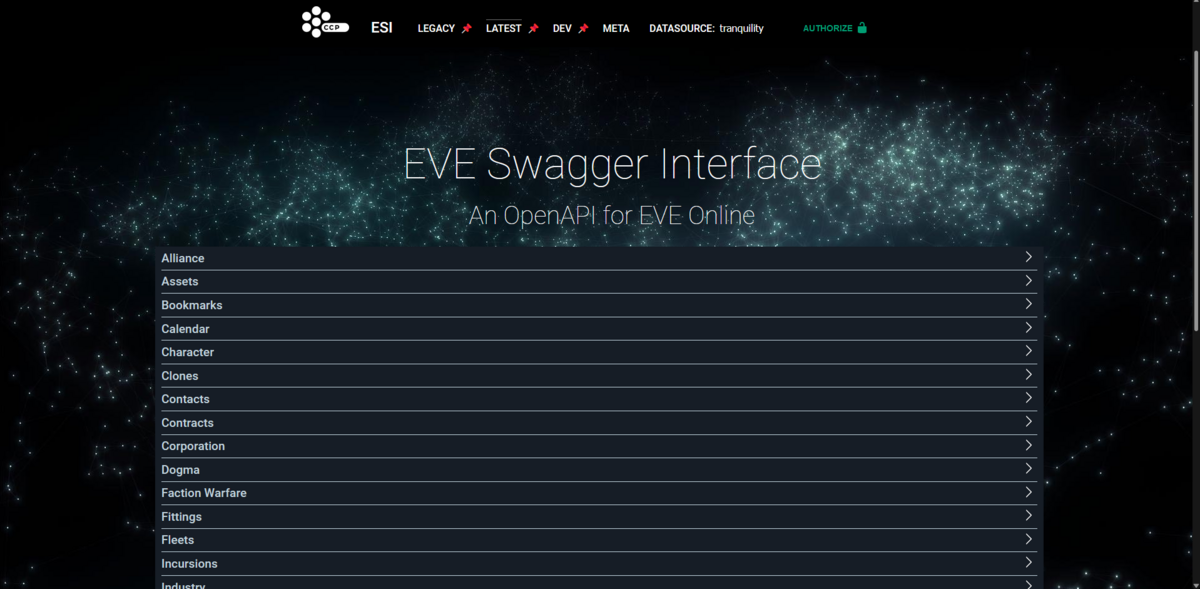
各カテゴリを選択すると、詳細が確認できます。右側に錠前のマークがついているAPIは認証が必要です。
IDの取り扱い
大抵のシステムがそうであるように、EVEではあらゆる存在に一意なIDが割り当てられています。IDの割り当て範囲はドキュメントで確認できます。
IDが既知であればそれを用いて情報を要求できますが、未知の場合はまずIDを確認しなければなりません。
IDの確認には/universe/ids/エンドポイントを利用します。
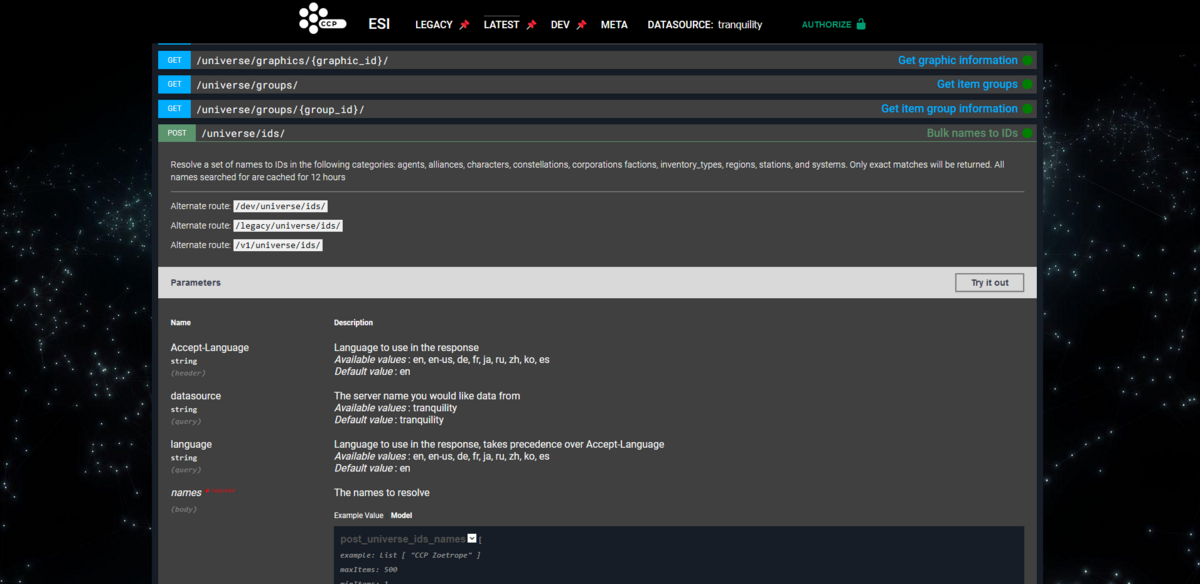
詳細画面でTry it out を選ぶと結果をAPIを試したり、Curlコマンドを生成できたりします。
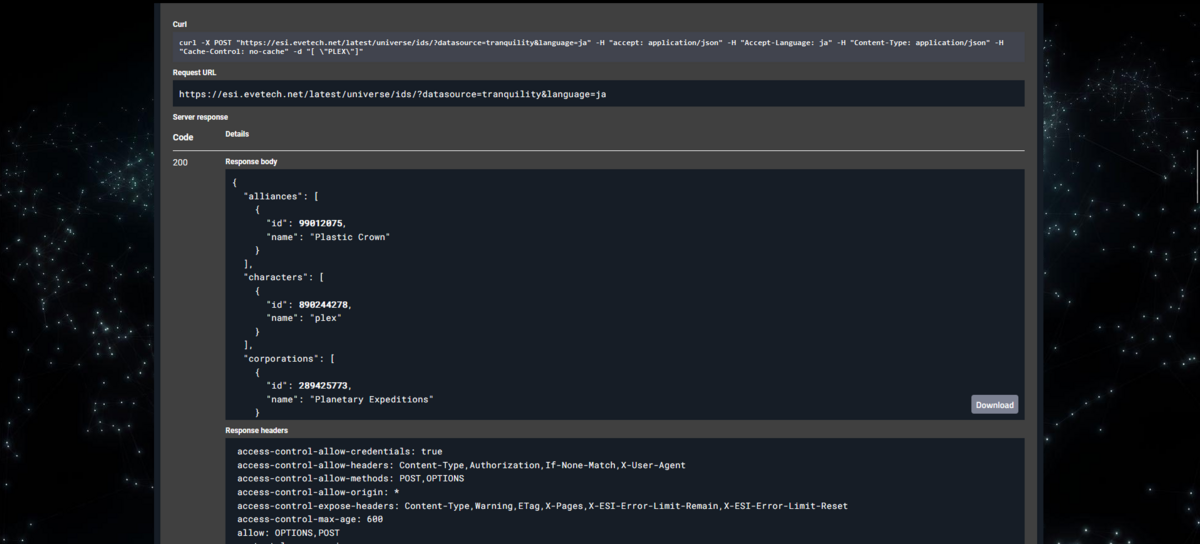
注意点として、/universe/ids/は完全一致のみ参照します。例えばDominixとDominix Navy Issueは同時検索できません。以前は部分一致で検索できるAPIがあったのですが、いつの間にか消えました。ユーザー名はともかくアイテム名は利用者側で名称とIDの一覧を保持しておけということかもしれません。
例えばDonimixとHyperionのIDを調べるプログラムをPythonで実装するとこんな感じになると思います。
注意ですがlanguageと問い合わせIDの言語は一致させる必要があります。language=enでドミニックスをPOSTしたりlanguage=jaでDominixをPOSTしても結果無しと帰ってきます。
import requests

url = "https://esi.evetech.net/latest/universe/ids/?datasource=tranquility&language=en"
payload = "[  \"Dominix\",  \"Hyperion\"]"
response = requests.post(url, data=payload)

print(response.status_code)
print(response.headers)
print(response.text)
実行結果
200
{'Date': 'Tue, 05 Sep 2023 13:11:26 GMT', 'Content-Type': 'application/json; charset=UTF-8', 'Content-Length': '165', 'Connection': 'keep-alive', 'Access-Control-Allow-Credentials': 'true', 'Access-Control-Allow-Headers': 'Content-Type,Authorization,If-None-Match,X-User-Agent', 'Access-Control-Allow-Methods': 'POST,OPTIONS', 'Access-Control-Allow-Origin': '*', 'Access-Control-Expose-Headers': 'Content-Type,Warning,ETag,X-Pages,X-ESI-Error-Limit-Remain,X-ESI-Error-Limit-Reset', 'Access-Control-Max-Age': '600', 'Allow': 'OPTIONS,POST', 'Content-Language': 'en', 'Strict-Transport-Security': 'max-age=31536000', 'Vary': 'Accept-Language', 'X-Esi-Error-Limit-Remain': '100', 'X-Esi-Error-Limit-Reset': '34', 'X-Esi-Request-Id': '853ae06e-9b59-46f6-bace-e4396001bfab'}
{"characters":[{"id":1093289919,"name":"Dominix"},{"id":144930206,"name":"Hyperion"}],"inventory_types":[{"id":645,"name":"Dominix"},{"id":24690,"name":"Hyperion"}]}
色々ヘッダーが付いていますが、本文は最後の行です。これらの名称はcharactersにも使用可能なので二つのカテゴリにまたがって結果が返ってきています。
Headerについて
いくつかESIに特有のヘッダーがあるので説明します。
まず前提として、ESIにはレート制限がありません(メール関連など一部を除く)。その代わりに、Error Rate Limitingというシステムがあります。
このシステムでは一定時間の枠内に一定回数以上の4XXおよび5XXエラーが発生すると残りの枠内では420エラーが返されます。このシステムによって間違ったリクエストを大量に処理したり5XXエラーが発生するほど過剰な量のリクエストが送られることを防いでいます。
このError Rate Limitingに関わるヘッダーがx-esi-error-limit-remainとx-esi-error-limit-resetです。
x-esi-error-limit-remainが0になるとAPIの利用が制限され、x-esi-error-limit-resetの時間(秒)が経過すると利用制限とx-esi-error-limit-remainの値がリセットされます。
つまり、x-esi-error-limit-remainが減るようであればAPIの使い方が正しいかを確かめたりアクセスが過剰になってないかを確認することが求められます。ちなみにこれを書いた時点では60秒で100エラーが制限のようでした。
このresponseのヘッダーにはありませんが、公式ドキュメントには他にexpiresとlast-modifiedヘッダーの存在も記載されています。
これは要求したデータがESIサーバーでキャッシュされている場合に使われ、expiresが次に新しいデータが取得されるまでの時間、last-modifiedがデータの取得タイミングです。
error-limitやexpiresで許容されているからといって不必要な規模や回数のリクエストはやめましょう。ESIは運営のリソースを浪費させないよう丁寧に使いましょう。規模が過剰の場合BANの可能性もあります。また、ESIはEVE本体と異なりストラクチャ探しなどの悪用目的での使用は禁止されています。今回は省略しましたが、ソフトウェアに組み込む際にはUserAgentに連絡先などを記載しましょう
とりあえずここまでまとめておきます。
その他のAPIの機能は実際に公式のページで確認してみてください。
何か指摘等あればコメントください
次回があれば認証が必要なAPIを触ってみます。
参考文献
Radxa ROCK 5BでIntel Realsenseを使う①
Radxa ROCK 5BでIntel Realsenseを使い、ROS2でSLAMを使う手順をメモしておきます。 今回はRealsense-viewerを実行するところまでやります。
使用機器
使用コンピュータ: Radxa ROCK 5B 8GB
SSD: KIOXIA EXCERIA G2 500GB
Intel Realsense D435i
使用機器の選択理由
Radxa ROCK 5B 8GB: Robocup junior WSOおよびRobocup SSLのレギュレーション内でSLAM可能なロボットを制作しようと考え、Jetson Orinよりは安いSBCとして購入
SSD:一部レビューで両面実装だと干渉するとの情報があったため、片面実装のものを使用
Intel Realsense D435i:今回の目的
充電器について
30W以上の給電をRock 5 Bは推奨していますが、USB PDのネゴシエーションに問題があり充電器やモバイルバッテリーでの給電に相性が存在します。手持ちのUSB電源で最も安定して利用でき、給電能力の高いAppleの20W充電器を使用しました。Realsenseも5W程度電力を消費するのでなるべく能力の高い電源が欲しいです。
公式Wikiの動作確認済みリストのリンクは以下 wiki.radxa.com
事前準備
事前にmicro SDなどを用いてブートローダーをMVMe SSDから起動できるよう書き換えておきます。eMMCやmicro SDから起動する形でも問題ないとは思いますが、速度や安定性の面でSSDを勧めます。
OS書き込み
まずはOSを書き込みますが、今回はUbuntuのGUIイメージをおすすめします。ROSをはじめ関連ソフトウェアはUbuntuを前提にしているのでこちらが無難だと思われます。具体的にはb36リリースの https://github.com/radxa-build/rock-5b/releases/download/b36/rock-5b_ubuntu_jammy_xfce_b36.img.xzを使用しました。
Armbianの公式イメージも存在しますが、執筆時点ではUSB PDに対応していないので今回は使っていません。
Balena etcherなどで書き込みましょう。
Realsense SDKのインストール
初期設定などが完了したら、Realsenseを動作するソフトウェアをインストールします。パッケージマネージャーなどからインストールする方法はうまくいかなかったので、ソースコードからビルドします。
基本的には以下のドキュメントに従い、Ubuntuへのインストール手順を実行します。
ただし、
Build and apply patched kernel modules for:
の項目は実行できませんのでやりません。詳細は詳しくないのですが、UVCやV4Lなどのカメラのドライバ周りの対応がプラットフォームにより異なるためこうなります。
代わりに、
cmake ../ -DBUILD_EXAMPLES=true
とするところを
cmake ../ -DFORCE_RSUSB_BACKEND=true -DBUILD_EXAMPLES=true
とするなど、DFORCE_RSUSB_BACKENDオプションをTrueにしてビルドします。
その後、コンパイル・インストールすれば完了です。コンパイルに時間がかかりますが、ファン付きのヒートシンクなどを使うと気持ち早くなります。
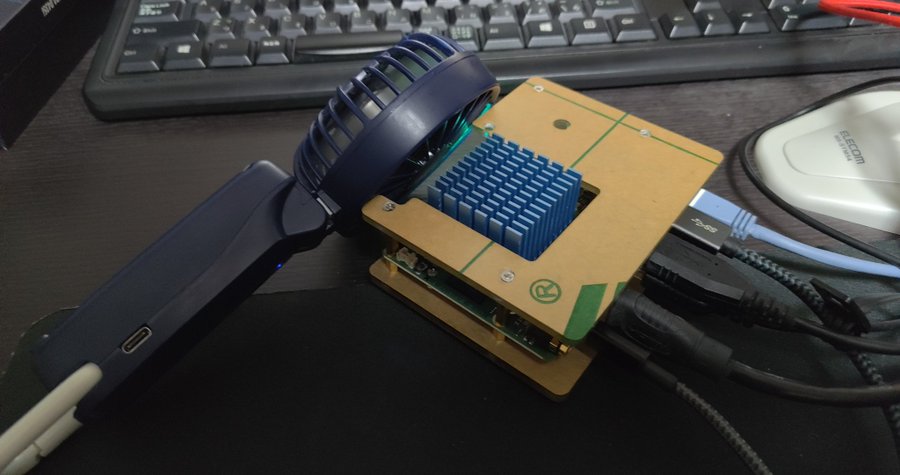
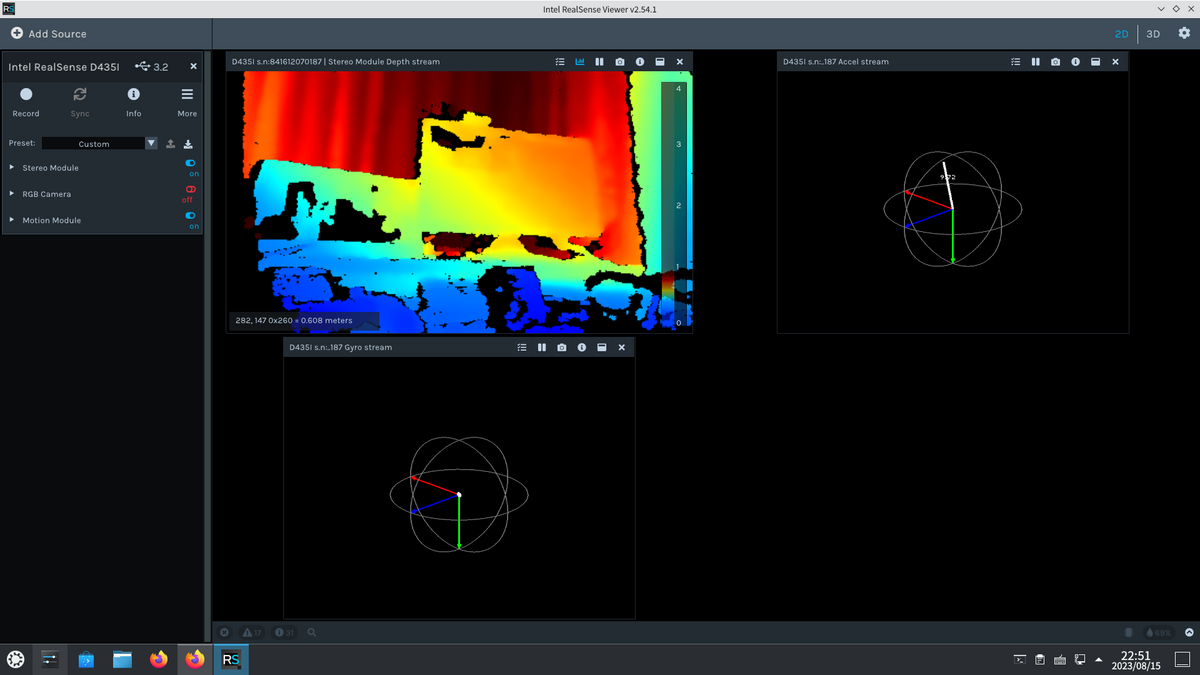
インストールが完了したらRealsense-Viewerを実行してインストールができているか確かめます。
何か問題点などあればコメントください。
参考文献
WSLとDockerを使ってWindowsでTensorflowとPytorchをCUDAを使える状態で共存させる
はじめまして、ふかふかです。
この記事はTCU-CTRL場外乱闘 Advent Calendar 2021 - Adventar15日の記事です。
ブログは初めてなので色々至らぬ点もあるかもしれませんが暖かい目でお願いします。
前回の記事はコットンさんです。
最近やってることについて書こうかと思ってましたが、環境構築で苦労したので備忘録も兼ねてやり方を記録しておきます。
いきさつ
普段の課題などでは手持ちのGeforceグラフィックボードを搭載したWindowsマシンでTensorflowを使っており、最近Pytorchを使う必要が出てきて環境構築の仕方を調べました。するとどうもGPU使用の前提となるCUDAのバージョンが競合しているようで、そのままでの両立は不可能なようでした。

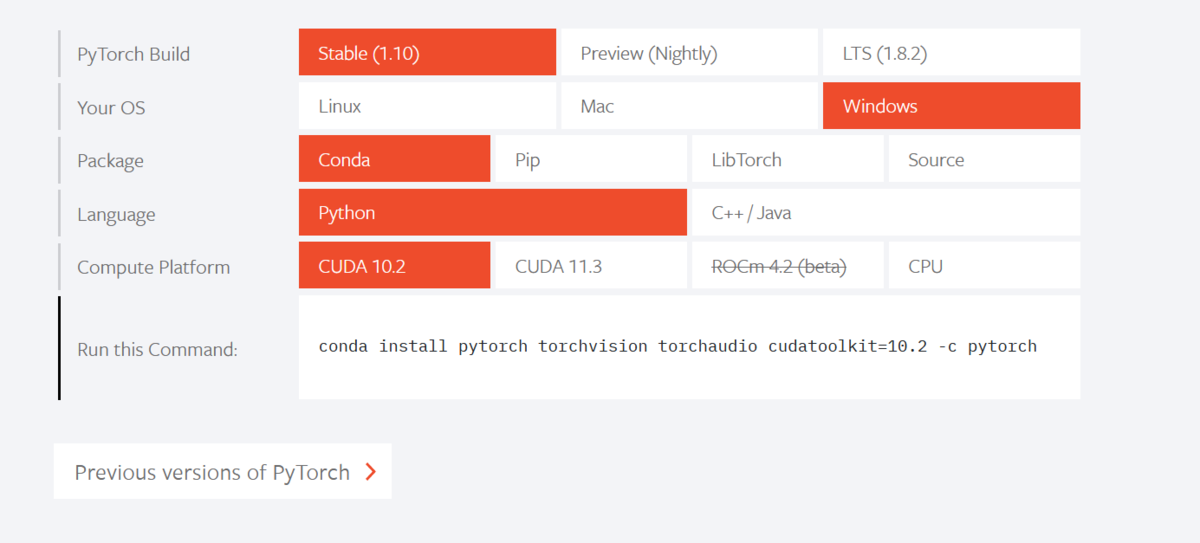
ご覧の通り要求するCUDAのバージョンが一致していません。Windowsで複数のバージョンのCUDAを両立させる方法を調べてみましたが、複数インストールして都度環境変数を変更するとかいうミスと不具合を誘発しそうなやり方しか見つかりません。
方針
そもそも事の原因は複数のバージョンのCUDAのpassが同一ということにあるようです。
そこでDockerを使います。幸い最近のWindowsにはWSL(Windows subsystem for Linux)というものがあります。これがあればWindows上でDockerを動かし、そこからCUDAやそれを要求するソフトウェアを動かせます。
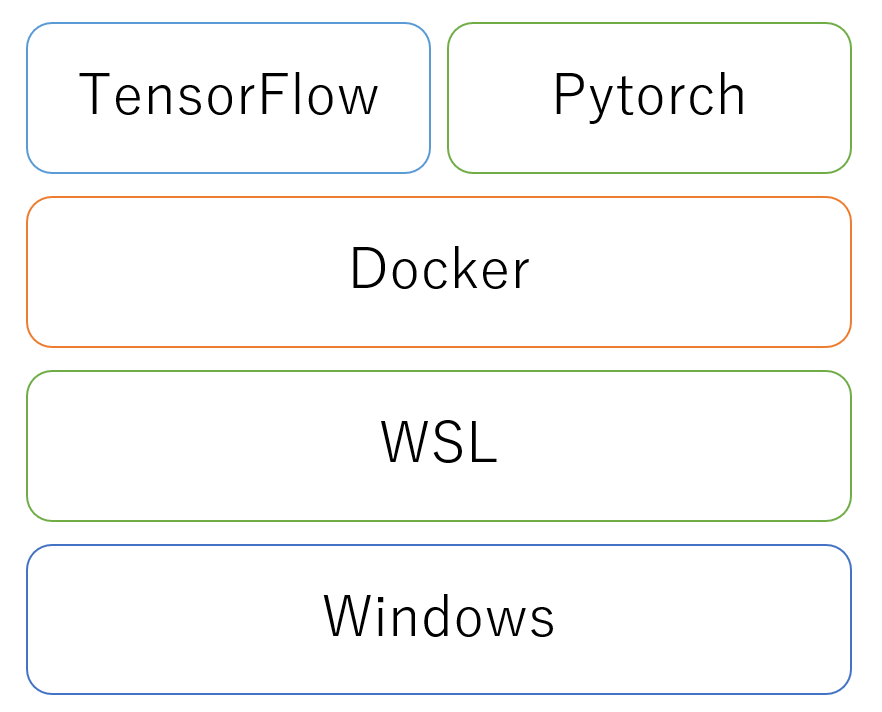
つまりどういうことかと言うと、Windows上でWSLでLinuxを動かし、Linux上でDockerを動かし、Docker ContainerでTensorflowやPytorchやその前提ソフトウェアを動かします(厳密には他のソフトウェアも関わったり、名前が正確じゃないですがイメージってことで)
この方法の難点は、動かせるのはLinux用のソフトウェアだけでWindows用のソフトウェアは対応しないという点です。TensorflowやPytorchは当然Linuxで動作しますが、Windowsのみのソフトウェアでは利用できません。じゃあ初めからLinux使えよとか言うな
WindowsコンテナというDockerでwindowsを動かす技術もありますが、そちらでCUDAを動かす方法というのは無さそうです。
準備
ここから本題です。
まず、今回実行した環境を示します。
- Windows 11 21H2 64bit
- i7-11700F
- Nvidia Geforce RTX 3080
OSについてはWin11を勧めます。後述しますが、WSLでGUIが簡単に使えるので便利です。Win10についても執筆時点(2021/12)でinsider preview版ではGUIに対応しているのでそのうち利用できるようになると思います。
また、今回は複数のCUDAの両立が問題なので、Nvidia GPUが必須です。と言うか、使用していない場合はそもそもこの記事の対象じゃないです。
加えて今回はVisual Studio Codeを使用します。簡単にコンテナに接続できるので便利です。
この記事ではDockerを使用しますが説明が面倒なので詳しい用語までは逐一説明しません。
WSLのインストール
まずはDockerを動かすWSLをインストールします。
wsl --install
上のガイドのようにPowerShellでインストールしてもよいですし、Microsoft Storeでディストリビューションを選んでインストールすることも可能です。

起動するとアカウントの作成を求められるので行いましょう。
WSL用CUDAドライバのインストール
次にWSL用のCUDAドライバーをインストールします。
developer.nvidia.comページ下部のGet CUDA Driver からダウンロードページに飛び、GeforceかQuadroの使用している方を選んでダウンロードします。
Visual Studio Codeのインストール
次にVSCode(Visual Studio Code)をインストールします。
azure.microsoft.comこちらも公式サイトでダウンロードしてもよいですし、wingetを使ってpowershellでインストールしてもいいです。
Docker Desktopのインストール
最後にDocker Desktopをインストールします。
インストール時にInstall required Windows components for WSL 2というオプションについて聞かれるのでチェックを入れます。(デフォルトで入っているはず。)
チェックを入れ忘れたとか既にインストールしている人はDocker DesktopのSettingから設定できます。
VScodeの設定
必要なソフトウェアのダウンロードが終わったので次はVSCodeの設定を行います。VScodeのRemote-Containersという拡張機能を使うことで、コンテナ内でVScodeを立ち上げてローカル環境のように開発を行うことができます。
拡張機能のインストールのためにVScodeを起動し拡張機能タブを開き、Remote Developmentをインストールします。
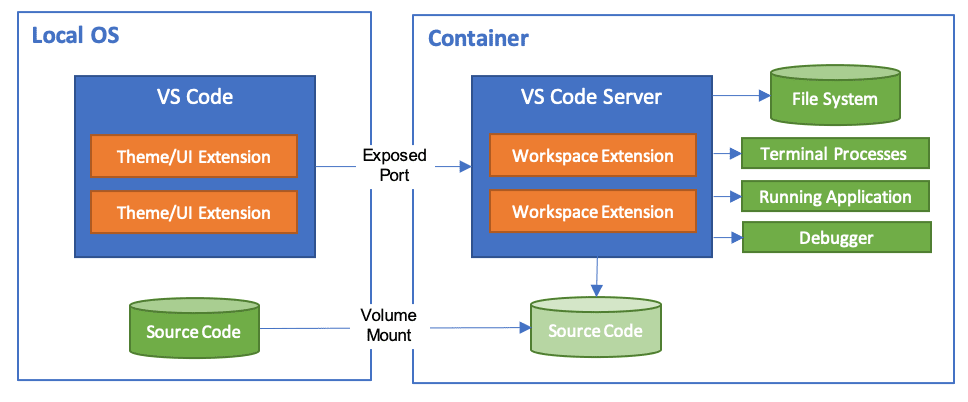
注意点として、コンテナ内でVScodeを使用する際VScodeの主体として稼働しているのは図のようにコンテナ内のVScodeサーバであることがあります。従って、Windows上のVScodeの拡張機能はUIをカスタマイズするタイプのものを除きコンテナ内のVScodeにインストールする必要があります。
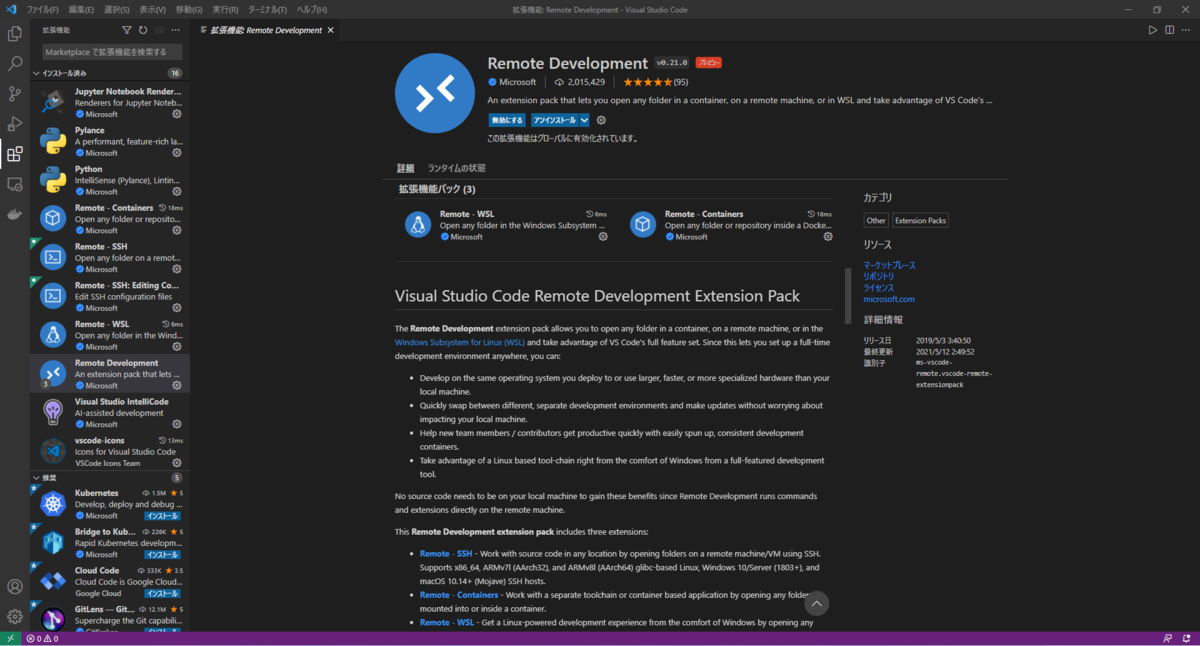
この拡張機能はRemote-WSL,Remote-Containers,Remote-SSHの三つの拡張機能がセットになっています。
WSLの設定
続けて、WSLでもいくつか設定をしていきます。まず、VScodeでWSLに接続します。左下の緑色の><が重なった感じのボタンを押します。
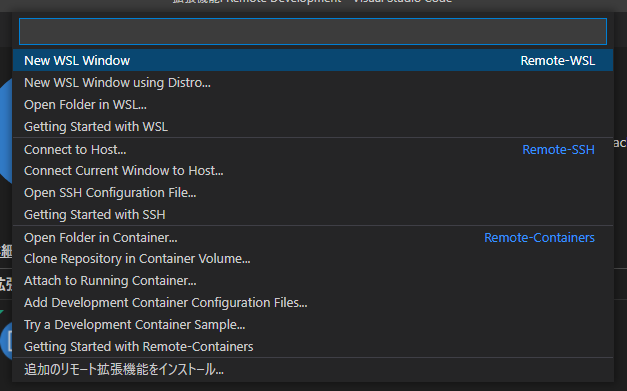
ここでNew WSL Windowを選び、WSLに接続します。
すると新しくウィンドウが開き、左下の表示がWSL:OS名になっていることが確認できます。これでVScodeでWSL上のファイルにアクセスできます。
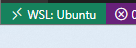
接続が確認できたら上のメニューからターミナルを選び、WSLのターミナルにアクセスします。別にVScodeでターミナルを開く必要性はないですが、ファイル編集が楽なのでこのまま続けます。
$ apt update
$ apt upgrade
$ apt install x11-xserver-utils
$ xhost local:
ターミナルを開いたら、x11-xserver-utilsをインストールします。apt updateやupgradeがまだならそちらもやっておきます。
このx11-xserver-utilsというのはLinuxでGUI表示に使われるX Window System関連のソフトで、これをインストールすることでマシンをxサーバとして利用できます。これによってDockerコンテナ上でGUIアプリが使えます。X Window SystemではGUIを使う側がサーバなのに注意してください。
また、この操作でGUIが使えるのはWSLgが利用できるWin11とWin10 insider previewのみです。執筆時点のWin10では対応していないので該当する方は別途Windows上にXサーバーアプリを用意するなどして対応してください。
そして末尾のxhost local:というのはX Windowのホストにlocalのアクセスを許可するという意味になります。あまりないシチュエーションかと思いますが、localからであれば全許可してしまうので多人数で使用するマシンの場合には注意してください。
最後にターミナルで
env
を実行し、その中からDISPLAY=の数値を確認しましょう。多分:0か0:0だと思います。
WSLの動作確認
ここからDockerの設定をする前に、一度WSLの動作確認をしてみましょう。まずLinuxがグラフィックボードを認識しているか確認するために
$ nvidia-smi
を実行します。
+-----------------------------------------------------------------------------+
| NVIDIA-SMI 510.00       Driver Version: 510.06       CUDA Version: 11.6     |
|-------------------------------+----------------------+----------------------+
| GPU  Name        Persistence-M| Bus-Id        Disp.A | Volatile Uncorr. ECC |
| Fan  Temp  Perf  Pwr:Usage/Cap|         Memory-Usage | GPU-Util  Compute M. |
|                               |                      |               MIG M. |
|===============================+======================+======================|
|   0  NVIDIA GeForce ...  On   | 00000000:01:00.0  On |                  N/A |
|  0%   45C    P8    40W / 320W |   1023MiB / 10240MiB |     N/A      Default |
|                               |                      |                  N/A |
+-------------------------------+----------------------+----------------------+

+-----------------------------------------------------------------------------+
| Processes:                                                                  |
|  GPU   GI   CI        PID   Type   Process name                  GPU Memory |
|        ID   ID                                                   Usage      |
|=============================================================================|
|  No running processes found                                                 |
+-----------------------------------------------------------------------------+
いくつかWSLの仕様上表示されないパラメータがありますが、グラボを認識していることがわかります。
次にGUI表示を試します。
$ xeyes
を実行します。win11ならGUIが起動するはずです。

便利な時代になりましたね。
コンテナ設定
ではここから実際にコンテナを作成します。
まずWSLで作業用のディレクトリを作成します。この記事ではホームディレクトリ直下にProject1という名前で作成していきます。この作業用ディレクトリがDockerコンテナにマウントされます。
ホームディレクトリにいろいろモノがあって紛らわしい場合はVScodeの左上のファイルからフォルダーを開くを選んで作成したディレクトリに移動しましょう。
Project1/
    └ .devcontainer/
        ├ Dockerfile
└ devcontainer.jsonディレクトリに移動したら、上の構成でフォルダとファイルを作成します。.devcontainerのドット'.'を忘れないように。
一ファイルづつ確認していきましょう。
まずはDockerfileです。最小構成はこんな感じです。
FROM nvcr.io/nvidia/pytorch:21.11-py3
# これはPytorchの場合
ENV TZ=Asia/Tokyo
RUN ln -snf /usr/share/zoneinfo/$TZ /etc/localtime && echo $TZ > /etc/timezone
RUN apt update && apt install -y x11-apps python3-tk
RUN pip install matplotlib
Dockerイメージは、NVIDIA のコンテナカタログから選びます。
コンテナカタログにアクセスしてTensorflowやPytorch等の必要なコンテナを選び(紛らわしいのが多いので注意!)右上のPull Tagを押すと、クリップボードにコンテナ名がコピーされます。そのままDockerfileに貼り付けると余計なコマンドまでついてくるので貼り付けたときに削除します。
また、Tensorflowが使いたい場合はこのイメージの部分をTensorflow用のイメージに変更してください。

このDockerfileはイメージの指定とGUI表示に必要なソフトをダウンロードするだけなので、別に必要なソフトウェアのインストールやユーザー生成、設定などは適宜Dockerfileに追記するかコンテナにログインして行って下さい。
TZ云々の設定をしているのは、ビルド中にTZを聞かれてビルドが止まるのを防ぐためです。
次にdevcontainer.jsonを編集します。
{
    "name": "TestProjectContainer", // コンテナ表示名
    "dockerFile": "Dockerfile", //Dockerfileの指定
    "workspaceMount": "source=${localWorkspaceFolder},target=/workspaces/Project1,type=bind,consistency=cached",// Workspaceとしてマウントするフォルダを指定
    "workspaceFolder": "/workspaces/Project1", // Workspaceのフォルダを指定
    "runArgs": ["--shm-size=1g" ,"--ulimit" ,"memlock=-1", "--ulimit","stack=67108864","--gpus","all","-it"],//その他引数を指定
    "mounts": ["source=/tmp/.X11-unix/,target=/tmp/.X11-unix,type=bind"],//マウントするフォルダを指定
    "containerEnv": {"DISPLAY":":0"}//変数の設定
}
このように設定します。基本的にはコメントの通りですが、最後の方はわかりにくいので説明します。"mounts"ではディレクトリをマウントすることでDockerホストのXサーバのソケットに接続します。
また、"containerEnv": {"DISPLAY":":0"}では先ほどメモしたWSLのDISPLAYの値を入力します。
それ以外にも使用する拡張機能などがあれば設定できます。詳しくは以下のリファレンスを参照して下さい。
実行
ここまで設定して、やっと準備が終わりました。
WSLを開いた時のように左下の緑のボタンを押し、開いたメニューからReopen Containerを選びましょう。ここまでの設定が間違っていなければ、イメージがビルドされてVScodeがコンテナにアクセスするはずです。(初回は時間がかかる)
また、原因不明の謎現象として、この時失敗してどうやってもビルドが通らなくなった時、Dockerfileを使用せずイメージ単体で一度コンテナを作成するとうまくいくようになります。
テスト
コンテナに接続できたら、GPU認識とGUIをテストしてみましょう。
まずはさっきも使ったnvidia-smiを実行してみましょう。
次にtorchのCUDA識別とgui機能を試します。
Pythonを起動し以下のコマンドを入力してみてください。
import torch

print(torch.__version__)
print(torch.cuda.is_available())#正しく認識していればTrue
さらにVScodeで適当なpythonファイルを作成し、以下のプログラムを実行してみましょう。
import numpy as np
import matplotlib.pyplot as plt

x = np.arange(0, np.pi * 2, 0.1)
y = np.sin(x)

plt.plot(x, y)
plt.show()
無事グラフが表示できたかと思います。

まとめ
このような方法でWindows上にDockerでグラフィックボードを用いた環境を実現できました。今回の例ではPytorchで構築しましたが、別ディレクトリに新たにdevcontainerを設定することで、容易にTensorflowの環境を用意できます。これでPytorchとTensorflowをwindows上に両立できるかと思います。
次回は
たちさんの記事です。よろしくお願いします。
参考サイト
CUDA on WSL :: CUDA Toolkit Documentation
Developing inside a Container using Visual Studio Code Remote Development
Dockerコンテナの中でGUIアプリケーションを起動させる | Unskilled?
